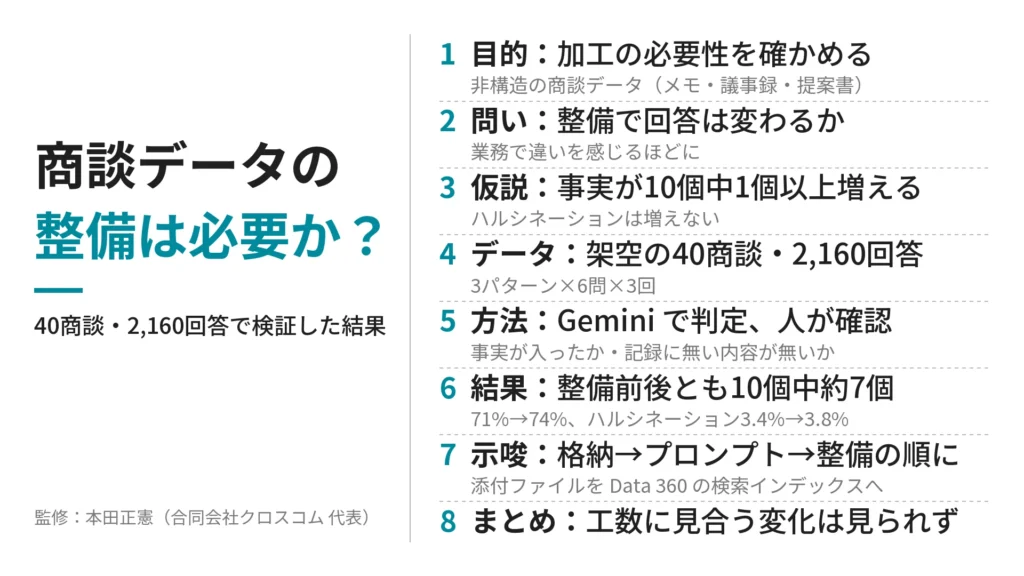
- 検証用データ:「商談メモ・添付ファイル・商談項目」データを使用
- データの設置:Data 360の使用有無も含めた3パターンで回答を比較
- エージェントへの質問:営業現場を想定して、1件の商談につき6つの設問を用意
- データ整備の内訳:「商談メモの書き直し」「添付ファイルの要点まとめ」「空欄の商談項目を埋める」
- 検証結果①データを整備しても回答の正確性は大きく変わらなかった
- 検証結果②回答から漏れた事実の多くは「見つけたのに書かれなかった」ものだった
- 検証結果③データを整備してもハルシネーションは減らなかった
- 検証結果④商談レコードの添付ファイルは、Data 360に格納しないと回答にほとんど使われなかった
- 示唆:Agentforceの回答を良くするには、「どの段階で事実が落ちているか」をまず確認する
- よくある質問
「商談メモをきれいに整えておけば、Agentforce はもっと正確に答えてくれるのでは?」。営業の活動データをAgentforceに読ませている担当者や責任者なら、一度はこう考えたことはありませんか?
実際に、担当者が商談レコードに格納している議事録や提案書のファイルは、AIエージェントが正しく読み取り生成しやすい形式になっているとは限りません。たとえば「来週の金曜」のような相対の日付や、複数のキーワードだけをメモしてつくられた文章、そして事実か担当者の推測か見分けができない論点など、担当者だけにしかわからない情報がたくさんあります。こうしたファイルデータを、Agentforce用に毎回修正してからSalesforce内に格納するのは、担当者にとってはかなり手間で面倒なことでしょう。
そこで私は、「商談データファイルをAIエージェントが探しやすく生成しやすいようにわざわざ加工するほど、回答内容に変化がある作業なのか?」と疑問に感じました。実際に、AIエージェントへのプロンプトを見直す前に、SalesforceのData 360をつかったRAGの精度を向上させるデータ整備の方法はいくつかありますが、そのデータ整備にどれだけの効果があるのかを数字で示したデータは見当たりません。
本検証では、Sandbox環境にて架空の40商談を用意し、データを整備する前と整備した後でAgentforce の回答を比べることで、この「商談データをAIエージェントが探しやすく生成しやすいようにわざわざ加工するほど、回答内容に変化がある作業なのか?」を実証していきます。
※個人情報保護の観点から、本検証では実在する企業の商談データは使っていません。Sandboxに架空の商談データを用意して確かめています。
- 非構造化の商談データを整備しても、答えてほしい事実10個のうち、回答に入ったのは整備前も整備後も約7個でした(整備前:71%→整備後:74%)
- データ整備前も整備後も、AIエージェントの回答から漏れた事実情報は、見つけられなかったのではなく、見つけたのに回答に使用しなかったのがほとんどでした。(つまり、回答の生成段階で一部漏れている)
- 非構造化の商談データを整備しても、事実に基づかない回答(ハルシネーション)の割合は大きく増えませんでした。(100回のAI回答のうち、整備前も整備後もかわらず3〜4回) 。
- 商談レコードに議事録や提案書ファイルを添付しただけでは、AIエージェントの回答にはほとんど使われませんでした(商談レコードに添付だけの場合:0.3%→Data 360の検索インデックスに格納した場合:64%)。
検証用データ:「商談メモ・添付ファイル・商談項目」データを使用
今回は、SalesforceのSandboxに、住宅会社向けのサービスを売る営業を想定した架空の商談を40件用意しました。1件の商談には、実際の営業活動を想定して次の3種類のデータを入れています。
| データ | 中身 |
|---|---|
| 商談メモ | 面談のたびに担当者が作成するメモ。主語の省略や「来週の金曜」のような相対の日付、略語、担当者の推測などが混ざっている。 |
| 添付ファイル | 商談レコードに添付している議事録や提案書(PDF)。 |
| 商談項目 | 金額、完了予定日、次のステップなど。一部は空欄のまま。 |
本検証では、1件の商談ごとにエージェントの回答に含めたい情報を12個に決めました。たとえば「見積の提出期日は2026年5月29日」「決裁者は取締役の村瀬さん」のような、実際に営業担当がメモとしてそのまま残しそうな長文テキストの中に含め、また12個のうち3割強は、商談レコードの添付ファイルにしか書かれていないようにしています。
データの設置:Data 360の使用有無も含めた3パターンで回答を比較
Agentforceで構築したエージェントは、ユーザーから質問を受けるとData 360の検索インデックスから質問の意味に近い順にデータを探して回答を生成します。そこで本検証では、Salesforce内のデータの格納場所を次の3パターンに分けて、回答を比べることにしました。
| 検証パターン | Data 360の検索インデックスに入れたもの |
|---|---|
| ①添付ファイルをData 360に格納していない | 商談メモと商談の項目だけ。添付ファイルはSales Cloudの商談レコードに添付しているが、中身はAgentforceから読めない |
| ②データを整備せずにData 360に格納した | 営業担当が作成した商談メモ・添付ファイル・商談の項目値を、そのままData 360に取り込み、検索インデックスを作成した |
| ③データを整備してData 360に格納した | 商談メモを整備したものに置き換え、添付ファイル(元のファイルと、書き出した要点)と空欄を埋めた商談項目をData 360に取り込み、検索インデックスを作成した |
※なお、本検証で実施した「データ整備」の内訳は後述します。
エージェントへの質問:営業現場を想定して、1件の商談につき6つの設問を用意
AIエージェントへの質問は、営業の現場でAgentforceを使う場面を想定して、以下の通り1件の商談につき6問を用意しました。
| 想定シーン | 実行者 | 質問 |
|---|---|---|
| 次の訪問の前日 | 営業担当 | この商談の状況を教えて |
| 次の訪問の前日 | 営業担当 | 次にやることを教えて |
| 週次の案件レビューの前日 | 課長 | この商談の決裁者と、懸念されている点は? |
| 着地見込みをつくるとき | 営業責任者 | この商談の予算と導入時期は確定している? |
| 担当の引き継ぎの後 | 後任の営業担当 | 顧客と約束していることは何? |
| 記録に答えがない質問 | 後任の営業担当 | 顧客との契約期間は何年の予定になっていますか? |
最後の「記録に答えがない質問」は、Salesforce内のデータに記載が無いことを聞かれたときに、Agentforceが「分からない」と正しく答えるかを確かめるために用意した質問です。この6つの質問を、3つのパターンそれぞれで3回ずつ聞き、計2,160回のエージェントの回答を集めました。※同じ質問を3回聞いたのは、同じ質問でも毎回少し違う答えを返すAIの性質を踏まえて、たまたまの結果にならないようにするためです。
また、今回GoogleのGeminiを用いて、以下2つの観点でエージェントの回答の正確性を判定しています。判定後は、私が40件の回答を目視で読み、Geminiの判定と合っているかも確かめています。
- 1つの回答ごとに、答えてほしい事実が入っているか
- 記録に無い内容を書いていないか。
データ整備の内訳:「商談メモの書き直し」「添付ファイルの要点まとめ」「空欄の商談項目を埋める」
データ整備は、AIを通して次の3つを行わせました(整備したデータを人が見直して直すことはしていません)。
商談メモを書き直す
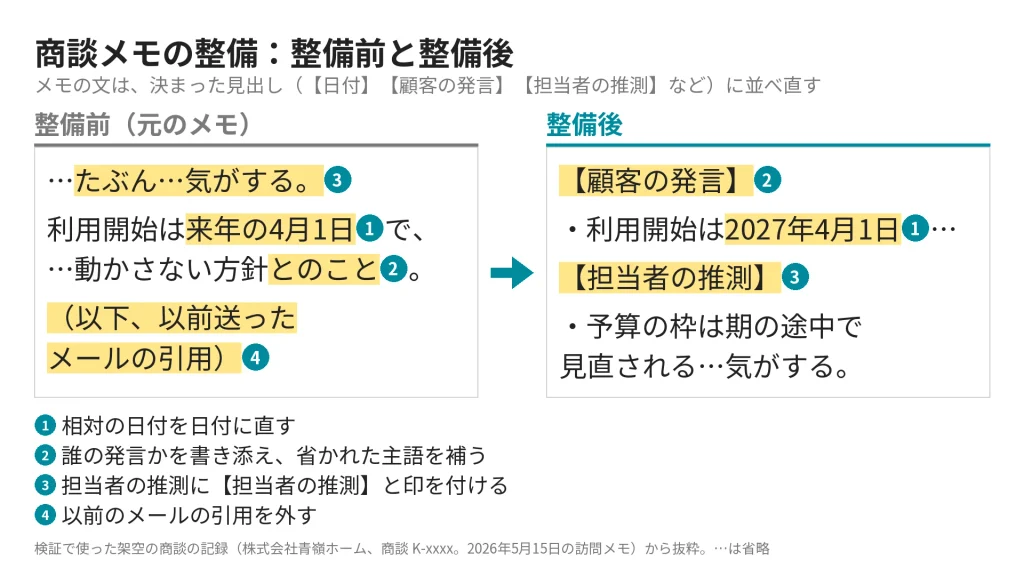
現場の商談メモは、担当者が面談の直後に急いで書くことが多く、書き方も人によってばらばらです。担当者本人が読めば分かる内容でも、AIエージェントにとっては「いつの話か」「誰の発言か」「事実か推測か」が読み取れないことがあります。
そこで、商談メモの整備として次の4つを行いました。
- 相対の日付を、面談の日付から計算して日付に直す(例:「来週の4月1日」→「2027年4月1日(来年の4月1日)」)
- 誰の発言かを書き添え、省かれた主語を補う
- 担当者の推測に【担当者の推測】と印を付け、事実と分ける
- メモに貼り付けられた、以前のメールの引用を外す
添付ファイルの要点を書き出す
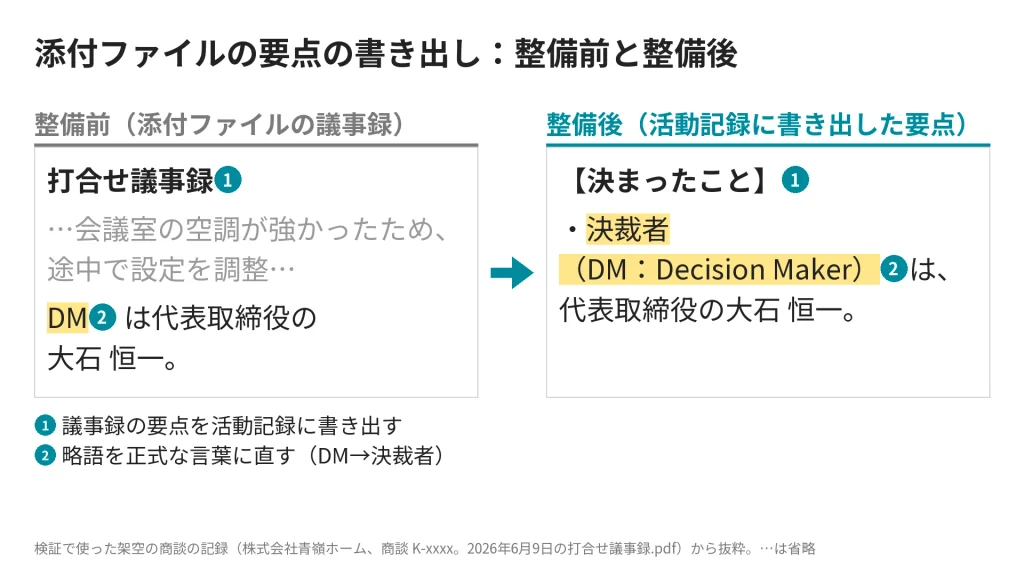
議事録や提案書は、PDF のファイルとして商談に添付されています。ファイルは文章が長く、表や図も混ざるため、AIエージェントが必要な一文を見つけにくいことがあります。そこで、次の2つを行いました。
- 議事録や提案書の要点を、商談の活動記録に書き出す
- 略語を正式な言葉に直す(例:「DM」→「決裁者」)
空欄の商談の項目を埋める
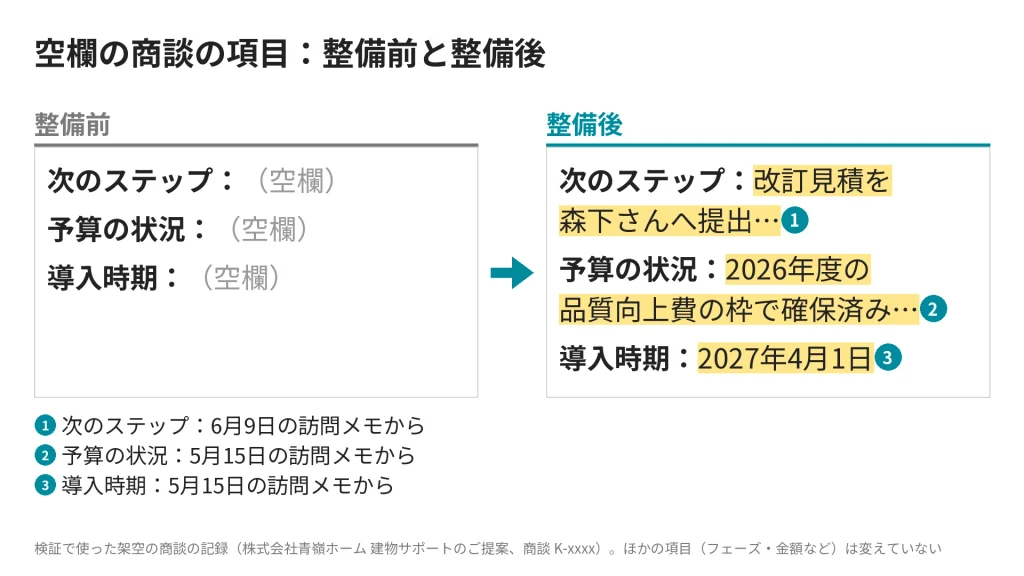
商談レコードには、「次のステップ」や「予算の状況」のような項目がありますが、忙しい担当者は空欄のままにしがちです。項目が空欄だと、その情報はメモやファイルの中を探さないと見つかりません。
そこで、メモやファイルから分かる値で、空欄だった次の3つの項目を埋めました。※もともと値が入っていた項目は変えていません。
- 次のステップ
- 予算の状況
- 導入時期
これらの検証設計を踏まえて、具体的にどんな結果になったのかを見ていきます。
検証結果①データを整備しても回答の正確性は大きく変わらなかった
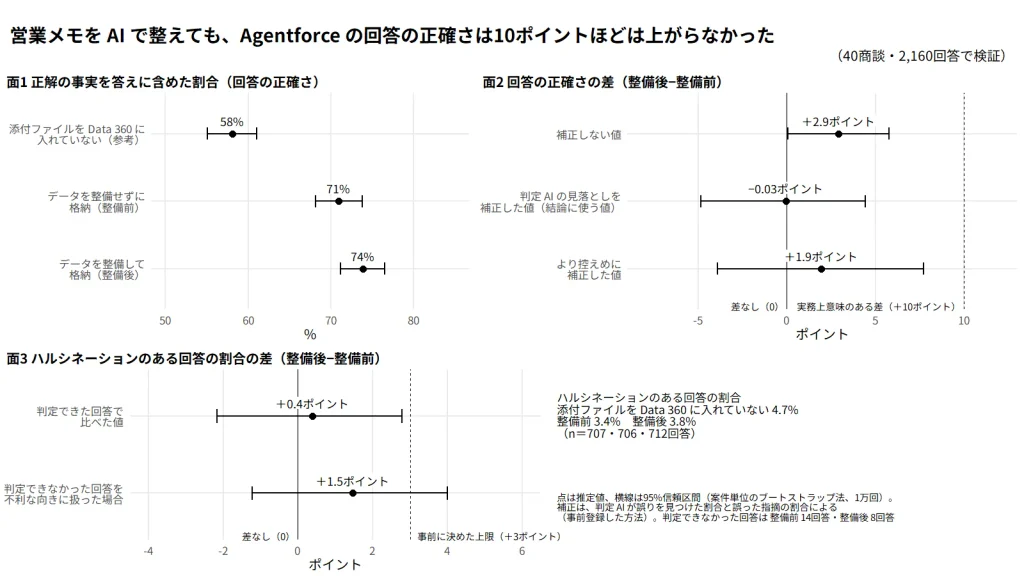
| 検証パターン | 答えてほしい事実のうち、回答に含まれた割合 |
|---|---|
| ①添付ファイルをData 360に格納していない | 58%(10個中およそ6個) |
| ②データを整備せずにData 360に格納した | 71%(10個中およそ7個) |
| ③データを整備してData 360に格納した | 74%(10個中およそ7個) |
まずAgentforceの回答の正確性ですが、上表の通り、①と②の差は13ポイント、②と③の差は3ポイントほどでした。しかし、もう少し具体的に回答内容を見ていくと、データ整備で良くなった回答と悪くなった回答の両方がありました。
たとえば「この商談の予算と導入時期は確定している?」という質問では、日付の回答に以下の違いが見られました。これは、データ整備で良くなった例です。
- 回答②:「利用開始は来年の4月1日で、ここは動かさない方針」・・・「来年」がいつを指すのか分からない。
- 回答③:「利用開始は2027年4月1日で、ここは動かさない方針」・・・具体的な日付が記載されていた。
また、「次にやることを教えて」という質問では、
- 回答②:「次にやることは、2026年7月28日に当社の日向が千草ホームを訪問し、森川取締役へ見積の内容を説明することです。また、2026年8月7日までに区画ごとの工程表案を提出することになっています。…全区画のSWSデータを7月24日までに長谷部さんへ送ることも記録されています」・・・3つの行動を、期日も含めてすべて書いている。
- 回答③:「次にやることは、以下の2点です。当社は2026年8月7日までに、区画ごとの工程表案を提出すること。2026年7月28日に、当社の日向が千草ホームを訪問し、森川取締役へ見積の内容を説明すること」・・・「2点です」と言い切るものの、SWS(地盤調査の一つ)のデータを送る行動が抜けている。
つまり、非構造化のデータをあらかじめ整備してData 360に取り込んでも、AIエージェントの生成する回答は一方的には良くならず、全体で見ると差はほとんど出ませんでした。
検証結果②回答から漏れた事実の多くは「見つけたのに書かれなかった」ものだった
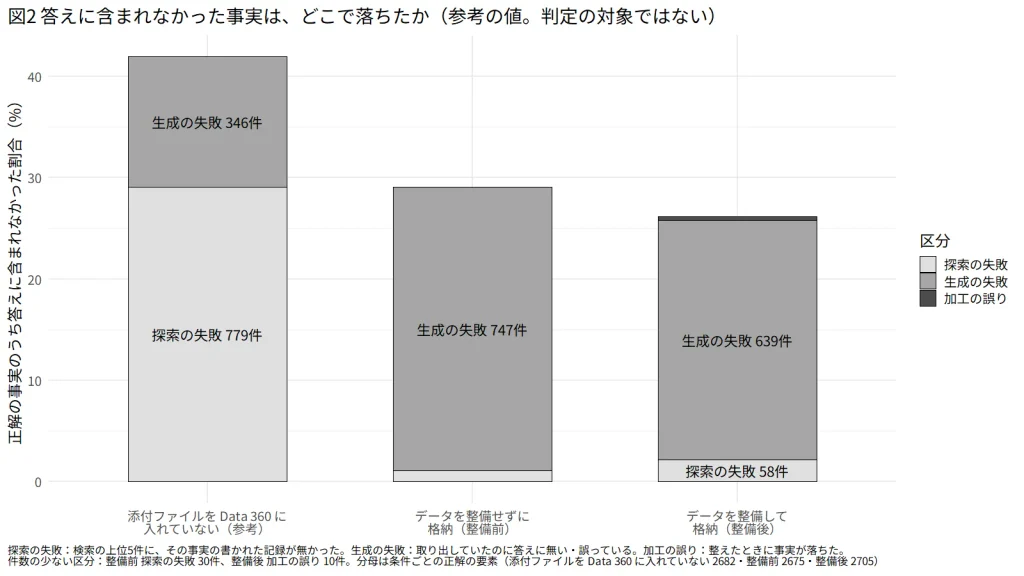
| 検証パターン | エージェントの生成回答から漏れた事実 | うち、検索段階で見つけられなかった | うち、見つけたのに回答段階で書かなかった |
|---|---|---|---|
| ②データを整備せずにData 360に格納 | 29% | 1% | 28% |
| ③データを整備してData 360に格納 | 26% | 2% | 24% |
※③にはデータ整備の段階で落ちた事実(0.4%)もあるため、2つを足しても26%と一致しません。
上表の通り、データの整備前も整備後も、エージェントの回答から漏れた事実のほとんどは、Agentforceが検索段階で見つけられなかったのではなく、見つけたのに回答段階で書かなかったものでした。
今回の検証では、Agentforceが検索で取り出す記録を5件に設定し、②のデータ整備前の時点で答えが書かれた記録がこの5件に入った割合は99%です。つまり、Agentforceはデータを整備する前から、必要なデータを99%発見できていたということです。
もう少し具体的にエージェントの回答を見ていくと、「正解が書かれた記録を取り出しているのに回答には書かれていない」という例もありました。
たとえば「次にやることを教えて」という質問では、データの中に「次にやること」が3つありました。そのうちの1つは「2026年7月17日までに、稟議に使う比較表を森本さんへ提出する」です。
- 回答②:「次にやることは、6月19日(金)までにサポ約款の最終版を森本さんへ提出し、6月23日(火)までに契約書案を作って森本さんへメールすることです」……比較表の提出が抜けている。
- 回答③:「2026年6月19日(金)までに建物サポート約款(サポ約款)の最終版を森本さんへ提出すること。2026年6月23日(火)までに契約書案を作成し、森本さんへメールすること。2026年7月17日(金)までに稟議用の比較表を森本さんへ提出すること」……3つとも書かれている。
回答②は、「比較表の提出」が書かれたデータ(添付ファイル「ご要望・お約束事項の整理」)を検索で1番目に取り出していましたが、それでもエージェントの生成回答には含まれませんでした。同じ質問を3回聞いて3回とも同じ結果だったため、エージェントの検索段階ではなく回答段階で落ちてしまったと考えられます。
つまり、データを整備することでエージェントが探しやすくなっても、もともと検索の段階でエージェントは、正解のデータの99%を取り出せていたため、効果は小さかったと考えられます。実際に事実が漏れていたのは、回答を生成する段階だったということです。
検証結果③データを整備してもハルシネーションは減らなかった
| 検証パターン | ハルシネーションがあった回答の割合 |
|---|---|
| ②データを整備せずにData 360に格納した | 3.4%(100回中3~4個) |
| ③データを整備してData 360に格納した | 3.8%(100回中3~4個) |
そのハルシネーションの数を、回答の数(②706回、③712回)で割っています。
データ整備では、担当者の推測に【担当者の推測】と印を付け、事実と推測を分けるように設計しました。推測と事実が分かれていれば、AIエージェントが推測を事実のように答えることは減るはずだと考えたからです。
しかし上表の通り、記録に無い内容を答えるハルシネーションは、100回の回答のうち整備前も整備後も3〜4回と、ほぼ変わりませんでした。
具体的にエージェントの生成回答の内容を見ていくと、推測に印を付けたのに、③の回答で推測を事実のように言い切った例がありました。たとえば「この商談の予算と導入時期は確定している?」という質問では、次の違いが見られました。
回答②:「予算が確定しているかどうかは…担当者の記録では『改良が必要な区画が増えたら予算が足りなくなるのではないか』と推測されています」・・・推測を「推測」として書いている。
回答③:「記録からは、予算と導入時期は現時点で確定していると読み取れます」・・・記録には「確定している」とは書かれていないのに、言い切っている。
なお、ハルシネーションの原因は、データ整備だったわけではありません。データ整備のときに、記録に無い内容が足されたのは1,266個中3個、事実が漏れたのは468個中1個で、ほとんどありませんでした。
つまり、「担当者の推測」と印を付けてデータを整備しても、AIエージェントが回答を生成する段階で推測を事実のように扱うことは、防げませんでした。このことから、エージェントのハルシネーションを減らすには、データ側ではなく、回答の書き方の指示で「推測は推測として書く」ことを決める必要があると考えられます。
検証結果④商談レコードの添付ファイルは、Data 360に格納しないと回答にほとんど使われなかった
| 検証パターン | 添付ファイルにしか書かれていない事実が、回答に入った割合 |
|---|---|
| ①添付ファイルをData 360に格納していない | 0.3%(781個中2個) |
| ②データを整備せずにData 360に格納 | 64%(10個中およそ6個) |
議事録や提案書のファイルを商談レコードに添付しておけば、Agentforceもその中身を読んで答えてくれると考えていました。しかし、添付ファイルをData 360に格納していない①では、上表の通り添付ファイルにしか書かれていない事実は、エージェントの生成回答にほとんど含まれませんでした。
具体的に回答を見ると、検証結果①と同じ「次にやることを教えて」という質問で、次の違いが見られました。正解の3つの行動のうち、行動1と行動3は、添付ファイル(打合せ議事録)にしか書かれていません。
| 次にやること | 書かれていた所 | 回答① | 回答② |
|---|---|---|---|
| 2026年7月28日に、森川取締役へ見積の内容を説明する | 添付ファイル | × | 〇 |
| 2026年7月24日までに、全区画の地盤調査(SWS)のデータを長谷部さんへ送る | 商談メモ | 〇 | 〇 |
| 2026年8月7日までに、区画ごとの工程表案を提出する | 添付ファイル | × | 〇 |
- 回答①:「次にやることは、全区画のSWSデータを7月24日までに長谷部さんへ送ることです。…記録からは、SWSデータ送付後の具体的な次のアクションや、他の担当者の動きについては分かりません」……商談メモにある行動2だけを書き、添付ファイルにある2つの行動が抜けている。
- 回答②:期日も含めて3つの行動をすべて書いている。
回答①は、添付ファイルの中身を読めないため、行動1と行動3が存在することすら分からず、「記録からは分かりません」と答えていました。
つまり、議事録や提案書のファイルは、商談レコードに添付しただけではAIエージェントの回答に使われません。Data 360に格納して検索インデックスに含めることでエージェントの生成回答に含まれるようになるということです。
補足:質問の場面によって差は異なる
| 想定シーン | 質問 | ②データ整備前 | ③データ整備後 |
|---|---|---|---|
| 次の訪問の前日 | この商談の状況を教えて | 48% | 44% |
| 次の訪問の前日 | 次にやることを教えて | 63% | 80% |
| 週次の案件レビューの前日 | この商談の決裁者と、懸念されている点は? | 88% | 92% |
| 着地見込みをつくるとき | この商談の予算と導入時期は確定している? | 89% | 94% |
| 担当の引き継ぎの後 | 顧客と約束していることは何? | 87% | 81% |
質問ごとに確かめた事実の数は約430〜790回と、回数が少ない分、全体の結果よりぶれが大きくなりました。また、上表の通り、データの整備で差が出た質問と出なかった質問がありました。
たとえば、「次にやることを教えて」では、回答に入った事実が10個中約6個から8個に増えました(63%→80%)。さらに、相対の日付が絶対の日付に直ったことも効果的だったと考えられます。
一方、「この商談の状況を教えて」のような広い質問では、差は見られませんでした(48%→44%)。もともと10個中約5個しか回答に入っておらず、整備しても増えていません。広い質問では、回答に書く事実を Agentforce が絞り込んでしまうため、データを整えても抜けが減らなかったと考えられます。「顧客と約束していることは何?」でも、差は見られませんでした(87%→81%)。
つまり、データ整備の効果は質問の種類によって違うということです。「次にやること」のように、エージェントが回答する事実の形が決まっている質問では効果的ですが、「状況」のように広い質問では効果は薄いということです。
ただし、上表の質問は5つの想定シーンを並べて比べた参考値ですので、1つの場面の差だけを取り出して結論にはしないでください。
示唆:Agentforceの回答を良くするには、「どの段階で事実が落ちているか」をまず確認する
Agentforceプラットフォームでエージェントの回答が不正確だと、担当者は「商談メモが整っていないからだ」と考え、データの整備から手を付けるかもしれません。しかし今回の検証では、Salesforceのデータを整備しても、エージェントの生成回答に含まれる事実は10個中約7個のまま変わりませんでした。
では、事実はどこで落ちていたのか。検証の結果を、Agentforce が回答を作るまでの3つの段階に分けて見ると、手を入れるべき所がはっきりします。
| エージェントのアクション段階 | Agentforceがしていること | 本検証で、事実が落ちた所 |
|---|---|---|
| 格納 | データがData 360の検索インデックスに入っている | 添付ファイルをData 360に取り込まないと、回答に含まれる事実が10個中約7個から約6個に下がった(検証結果④) |
| 検索 | ユーザーの質問の意味に近い情報を、検索で取り出す | 探索段階では、正解のデータの99%を取り出せていた(検証結果②) |
| 生成 | 取り出した記録を読んで、回答を書く | 回答の生成段階で探している情報が、②で約3割、③で約4分の1、生成回答から落ちた(=見つけたのに含めなかった:検証結果②) |
データの整備は、主に検索段階の精度を良くするための作業です。しかし、検索段階では、データを整備していなくても事実がほとんど落ちていませんでした。データ整備の効果がほとんどなかったのは、事実が落ちている段階が検索段階ではなく生成段階だったからといえます。
示唆①確認の順番は「データの格納場所」→「プロンプト」→「非構造化データの整備」
今回の結果から考えると、Agentforce の回答を良くするために手を入れる順番は、次のようになります。
データの格納場所:添付ファイルを Data 360 の検索インデックスに入れる
議事録や提案書は、商談レコードに添付しただけでは、エージェントの生成回答に含まれません。実際に、添付ファイルをData 360に格納して検索インデックスに含めるだけで、回答に入る事実は10個中約6個から約7個に増えました。
プロンプト:エージェントの回答形式を設計する
答えてほしい事実が最も多く落ちていたのは、回答を生成する段階です。エージェントへの回答指示(プロンプト)で、「取り出した情報にある事実を漏らさず書く」「次にやることは期日と一緒に時系列で書く」のように、回答形式を設計することが重要だと考えられます。
非構造化データの整備:商談メモや添付ファイルの書き直しは、その後に場面を絞る
商談メモや添付ファイルのような非構造化データを全体的に整備しても、回答はほとんど変わりませんでした。非構造化データを書き直すなら、次の示唆②のように、効果が出た場面に絞るのがよいと考えます。
まずは、自社の Agentforce が検索している検索インデックスに、商談の添付ファイルが入っているかを確かめてください。
示唆②非構造化データを整備するなら、「探しやすく」ではなく「そのまま回答に使える形」に
データ整備の効果は、質問によって違うことが分かりました。たとえば、質問「次にやることを教えて」では、回答に含まれた事実が10個中約6個から8個に増えた一方で、「この商談の状況を教えて」では増えませんでした。
この違いは、整備で何が変わったかを見ると説明できます。検証結果①の事例をもう一度見てみます。
- データ整備前の記録:「利用開始は来年の4月1日で、ここは動かさない方針」
- データ整備後の記録:「利用開始は2027年4月1日(来年の4月1日)で、ここは動かさない方針」
データを整備する前も、エージェントはこの記録を検索で取り出せていました。しかし、「来年」がいつなのかは記録だけでは分からないため、回答も「来年の4月1日」のままでした。このように、データを整備した後のデータでは、日付が絶対形式で記載されていたため、エージェントはそれをそのまま回答に使えたと考えられます。
つまり、データ整備による効果が発揮されたのは、情報を「探しやすく」したからではなく、情報を「そのまま回答に使える形」にしたからだと考えられます。今回の検証では、検索段階はもともとほとんど落ちていなかったので、「探しやすく」する整備には効果の余地がありませんでした。
ここから、データを整備するときに担当者が優先すべき対応が見えてきます。
- 相対的な日付を絶対的な日付に直す(例:10月7日のメモの「来週の水曜日」→「2026年10月14日」)
- 次にやることを、「いつまでに・誰が・誰に・何を」をセットで書く(例:「【次】6/23までに契約書案作ってメール」→「2026年6月23日までに当社が森本さんへ契約書案をメールで送る」)
- 社内の略語を正式な言葉に直す:(例:「サポ約款」「DM」→「建物サポート約款」「決裁者」)
※商談メモ全体を決まった見出しに並べ直す整備は、「探しやすく」するための作業です。今回の検証の条件では、その効果ははっきりしませんでした。
ただし、この検証では、整備の作業を1つずつ分けて効果を測ってはいません。自社でデータ整備を始めるときは、まず「次にやること」のように効果が出やすい質問に絞り、上の3つの作業から試して、回答が変わるかを確かめてください。
よくある質問
Q1. 商談メモをAIで整備すれば、エージェントの回答は正確になりますか?
正確性は大きく変わりませんでした。検証結果の通り、答えてほしい事実10個のうち、回答に入ったのはデータの整備前も整備後も約7個でした(整備前71%→整備後74%)。判定の見落としを補正すると、データの整備前と整備後の差はほぼありません。
Q2. 議事録や提案書のファイルは、商談レコードに添付すれば Agentforce に読まれますか?
商談レコードにファイルを添付しただけではほとんど読まれません。添付ファイルにしか書かれていない事実が回答に含まれたのは、Data 360に格納していない場合で781個中2個(0.3%)、Data 360 の検索インデックスに格納した場合で64%でした。
Q3. エージェントの回答から事実が抜けてしまうのはどの段階ですか?
回答の生成段階で抜けていました。Agentforceは、検索の段階では正解が書かれた情報の99%を取り出せていましたが、エージェントに答えてほしい事実のうち、②で約3割、③で約4分の1は、データを取り出していたのに生成回答に含まれませんでした。
Q4. 担当者の推測に印を付けてデータを整備すれば、ハルシネーションは減りますか?
減りませんでした。データに無い内容を答えたハルシネーションは、100回の回答のうち整備前も整備後も3〜4回でした(整備前3.4%→整備後3.8%)。「担当者の推測」に印を付けても、回答生成の段階で推測を事実のように言い切った例があったため、データ側だけでは防げませんでした。
Q5. データの整備が効果的になる場面はありますか?
ユーザーの質問次第で変わります。たとえば、「次にやることを教えて」では、エージェントの生成回答に含まれた事実が10個中約6個から8個に増えました(63%→80%)。一方で、「この商談の状況を教えて」のような広い質問では増えませんでした。したがって、データを整備するなら、相対の日付を絶対の日付に直すなど、エージェントがそのまま回答に使える形に整備することに絞るのが効果的だと考えられます。
Q6. エージェントの回答を良くしたいとき、まず何から手を付ければよいですか?
今回の結果からは、「データの格納場所」→「プロンプト」→「非構造化データの整備」の順をおすすめします。まず、添付ファイルが Data 360の検索インデックスに入っているかを確かめ、次にエージェントの回答形式をプロンプトで決めます。ただし、プロンプトを変えたときの効果はこの検証では試していません。
Q7. この検証は、どのようなデータと方法で行いましたか?
SalesforceのSandbox に用意した架空の商談40件で、データの置き方を3パターンに分け、1件6問を3回ずつ聞いた、計2,160回の回答を集めました。回答の正確性はGoogleのGeminiで判定し、そのうち40件を私が目視で読んで確かめましたが、Geminiの判定と合ったのは約8割でした。
まとめ:非構造化データを整備する前に、「格納場所」と「プロンプト」を見直す
今回の検証テーマ「商談データを、AIエージェントが探しやすく答えやすい形にわざわざ整えるほど、回答の正確さは変わるのか?」に対する結果は、「商談データ全体を整備しても、回答の正確さは大きく変わらない」でした。このことからも、非構造化データの整備で業務に大きなインパクトが期待できるわけではなさそうです。
一方で、本検証からはデータ整備より先に手を入れるべきことも見えてきました。
- 添付ファイルをData 360の検索インデックスに格納する
- プロンプトでエージェントの回答形式を決める
- 非構造化データを「そのまま回答に使える形」に場面を絞って整備する
ただし、プロンプトで回答の書き方を決めたときに、回答がどれだけ良くなるかは、この検証では試していません。次の検証では、プロンプトの書き方のパターンごとに、回答の正確さとハルシネーションがどう変わるかを確かめる予定です。
クロスコムでは、本記事で紹介したような検証を自社のSandboxで行いながら、その結果をAgentforceの導入・定着の支援に活かしています。
- 添付ファイルや商談メモがAgentforceの検索インデックスに入っているかの点検
- 自社の商談データを使った「回答の正確さ」と「ハルシネーション」の検証
- 回答形式を設計する、Agentforceのプロンプトの見直し
「まず自社の Agentforce がどれくらい正しく答えているかを知りたい」という段階からお手伝いできますので、お気軽にお問い合わせください。