月末になるたびに、パイプラインの着地見込みが大きく動いてしまう。フォーキャストを出しても、実績とのズレが毎月のように起きる、という営業組織は多いのではないでしょうか。パイプライン予測とは、進行中の商談の受注確度を積み上げ、将来の売上着地を見通す活動です。しかし、その精度は担当者の感覚に左右されやすく、四半期のフォーキャストと着地の差は、多くのB2B業種で8%から15%に収まり、精度の高い組織では95%を超えるとする整理もあります。※参考記事はこちら
そこで本記事では、パイプライン予測の精度をAgentic CRMがどう高めるのかを、受注確度を固定値で扱う「静的確度」から、AIが常時見直す「動的確度」への転換という観点で解説します。
- パイプライン予測が毎月ブレる3つの原因
- 静的で足りる?受注確度を動的に変える仕組み
- AIが使う予測精度向上の3つのシグナル
- 場面3選|パイプライン予測が自律更新されるとき
- なぜ外れる?パイプライン予測の失敗パターン3選
- 予測精度の向上が機能する企業の条件
- 予測精度の向上を急がなくてよい企業の特徴
- どこから始める?パイプライン予測を自律更新する5ステップ
- パイプライン予測精度向上で追うフェーズ別KPI
- パイプライン予測精度向上の費用感
- 【一問一答】Agentic CRMを使ったパイプライン予測精度向上でよくある質問
- パイプライン予測がブレる本質的な原因は「担当者の感覚値」と「CRMデータの劣化」にある。Agentic CRMは活動データを自動収集してAIが受注確度を動的更新することで予測誤差を縮小する
当社は、AIが読み書きする前提のCRMを業務設計から貴社専用に設計する、Agentic CRM設計支援を行っています。
・顧客ごとに対応を変えたいが、人手が足りない
・CRMは入れたが、データが営業の判断に使えていない
・AIエージェントの活用を見据えて、CRMの設計から相談したい
というお悩みがあればお気軽にご相談ください。業務課題のヒアリングと現在地の整理から一緒に進めます。
この記事を書いた人
合同会社クロスコムの代表|専門商社にて7年間のBtoB営業を経て、マーケティング業界に参入。現在はSalesforce公式コンサルティングパートナーとして、ソリューション営業の業務プロセスに特化したAgentforce導入・定着支援と、Agentic CRM設計支援を提供している。Salesforce認定アドミニストレーター・Sales Cloudコンサルタント・Marketing Cloud Account Engagement スペシャリスト。
パイプライン予測が毎月ブレる3つの原因
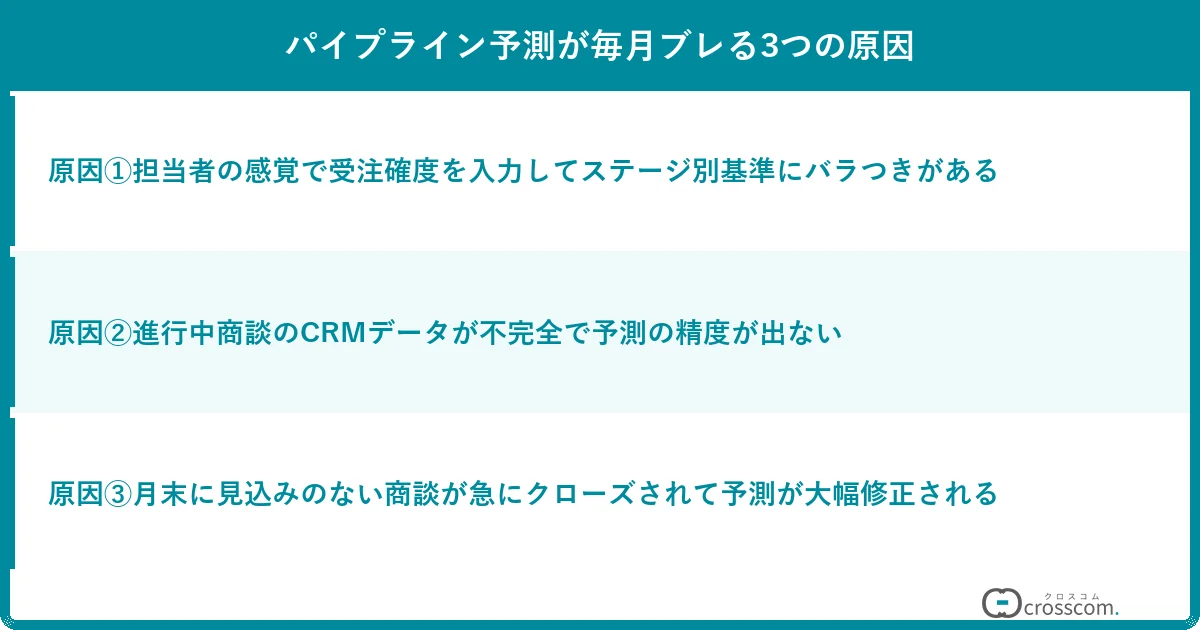
まずは、パイプライン予測が毎月ブレてしまう原因を整理します。今回は、業務用の予約管理システムを提供する中堅SaaS企業を例に考えていきます。この企業は営業担当が12名おり、CRMを導入して月次でフォーキャストを作成していました。ところが、その着地見込みは毎月20%以上もブレ、四半期の目標に対して着地が読めない状態が続いていました。なぜ、CRMで数字が見えているのに、予測はこれほど外れるのでしょうか。ここでは、その3つの原因を整理します。
原因①担当者の感覚で受注確度を入力してステージ別基準にバラつきがある
1つ目の原因は、受注確度を担当者の感覚で入力していて、ステージごとの基準がばらついていることです。
なぜなら、同じ「確度70%」でも、ある担当者は最終見積もり後にしか付けず、別の担当者は初回提案の段階で付けてしまうと、積み上げた予測の意味が変わってしまうからです。
たとえば、先ほどの予約管理システムの企業では、受注確度の入力ルールが決まっておらず、各担当者が自分の感覚で数字を付けていました。楽観的な担当者は、まだ提案もしていない商談に確度60%を入れ、慎重な担当者は受注寸前でも50%のままにしていました。その結果、同じ確度でも中身がまったく違い、合計した予測は実態とかけ離れていました。
このように、確度の基準が人によって違うと、積み上げた予測の全体が信頼できなくなります。
原因②進行中商談のCRMデータが不完全で予測の精度が出ない
2つ目の原因は、進行中の商談のCRMデータが不完全で、予測の精度が出ないことです。
なぜなら、受注や失注が確定した商談は記録が細かく残る一方、進行中の商談は活動の記録が虫食いになりやすく、予測に使えるデータの質がそろわないからです。
たとえば、この企業では、受注した商談には商談録音や議事録がひととおり残っていましたが、進行中の商談は、次回アクション日すら入っていないものが多くありました。予測は、このデータの薄い進行中商談を材料に立てられます。材料が欠けたまま数字を積み上げても、着地見込みは実態を映しませんでした。受注した商談の記録がどれだけ整っていても、進行中商談のデータが薄ければ、予測の精度はそこで止まってしまいます。
このように、進行中商談のデータが不完全なままでは、予測の精度は上がりません。
原因③月末に見込みのない商談が急にクローズされて予測が大幅修正される
3つ目の原因は、月末になって見込みのない商談が一気にクローズされ、予測が大幅に修正されることです。
なぜなら、停滞していた商談が月末の見直しでまとめて失注処理されると、それまで積み上げていた予測が急に下方修正されるからです。
たとえば、先ほどの企業では、月の中頃までは目標達成が見えていたのに、月末の数日で複数の商談が「今月は決まらない」と判断され、着地が20%以上も下振れすることが繰り返されました。マネージャーは月末になるまで本当の着地が読めず、経営への報告が二転三転していました。部門をまたいで同じ数字を見る形に収益プロセスを通す考え方はRevOpsの記事で扱っています。
予測が毎月大きくブレる背景には、確度が担当者の感覚に委ねられ、進行中商談のデータが不足しているという共通の構造があります。
静的で足りる?受注確度を動的に変える仕組み
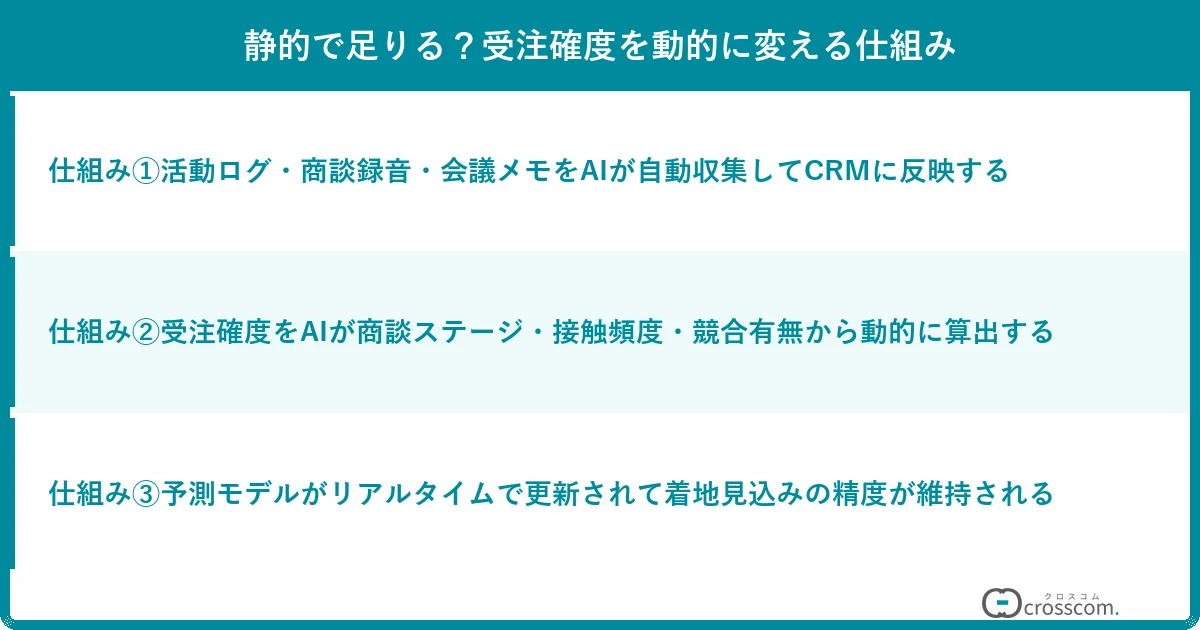
ここまで、パイプライン予測が毎月ブレる3つの原因を整理してきました。これらの原因には、一つの共通した構造があります。それは、受注が確定した商談のデータは充実し、進行中の商談のデータは不完全だという非対称性です。予測モデルは、記録の整った過去の受注商談に引っ張られ、実際より楽観的な着地を示しやすくなります。これがCRMの「過去バイアス問題」です。ここでは、この構造を、受注確度を固定して扱う「静的確度」から、AIが常時見直す「動的確度」へと変える、Agentic CRMの3つの仕組みを解説します。
| 観点 | 静的確度(従来) | 動的確度(Agentic CRM) |
|---|---|---|
| 確度の決め方 | 担当者の感覚で固定的に入力する | AIが複数の事実から自動で算出する |
| 更新のタイミング | 月次レビューなど不定期 | 商談が動くたびリアルタイムで更新 |
| 使うデータ | 手入力の断片的な記録 | 活動ログ・商談録音・会議メモ |
| 予測のブレ | 月末に大きく修正されやすい | 実態に追随しブレが小さい |
仕組み①活動ログ・商談録音・会議メモをAIが自動収集してCRMに反映する
1つ目の仕組みは、活動ログや商談録音、会議メモを、AIが自動で収集してCRMに反映することです。
なぜなら、進行中商談のデータ不足を埋めるには、担当者の手入力に頼らず、やり取りの事実を自動で集める必要があるからです。
たとえば、先ほどの予約管理システムの企業では、オンライン商談の録音や、メール・通話の履歴をCRMに自動で連携する設定にしました。担当者が議事録を書かなくても、AIが商談の音声から要点を抽出し、顧客が何を懸念していたかがCRMに残るようになりました。これまで担当者の頭の中にしかなかった顧客の関心の度合いが、データとして記録されます。進行中商談のデータの欠けが、大きく埋まりました。
このように、対話データまで自動で集めることが、動的確度の材料をそろえる出発点になります。
仕組み②受注確度をAIが商談ステージ・接触頻度・競合有無から動的に算出する
2つ目の仕組みは、受注確度を、AIが商談ステージや接触頻度、競合の有無から動的に算出することです。
担当者が感覚で付けた固定の確度ではなく、複数の事実にもとづいてAIが確度を計算すれば、基準のばらつきがなくなるからです。
たとえば、この企業では、AIが商談ステージ・直近30日の接触頻度・競合の有無・過去の類似商談との一致度を組み合わせて、受注確度を自動で算出するようにしました。担当者が「たぶん70%」と感じていた商談も、接触が2週間途絶えていれば、AIは確度を下げて表示します。確度が事実にもとづくため、月次で積み上げた予測が実態に近づきました。
このように、確度を事実から動的に計算することで、予測の起点となる数字が信頼できるものになります。
仕組み③予測モデルがリアルタイムで更新されて着地見込みの精度が維持される
3つ目の仕組みは、予測モデルがリアルタイムで更新され、着地見込みの精度が保たれることです。
なぜなら、商談は日々動いており、確度を月に一度しか見直さなければ、月の途中で状況が変わっても予測に反映されないからです。
たとえば、先ほどの企業では、商談の状況が変わるたびにAIが確度を計算し直し、着地見込みが自動で更新されるようにしました。ある大型商談で競合が新たに現れた日には、その商談の確度が下がり、全体の着地見込みも即座に修正されました。マネージャーは月末を待たず、いつでも最新の着地を確認できるようになりました。
受注確度を固定値のまま置くのをやめ、AIが常時計算し直す動的確度に変えることが、予測精度を保つ中心になります。
AIが使う予測精度向上の3つのシグナル
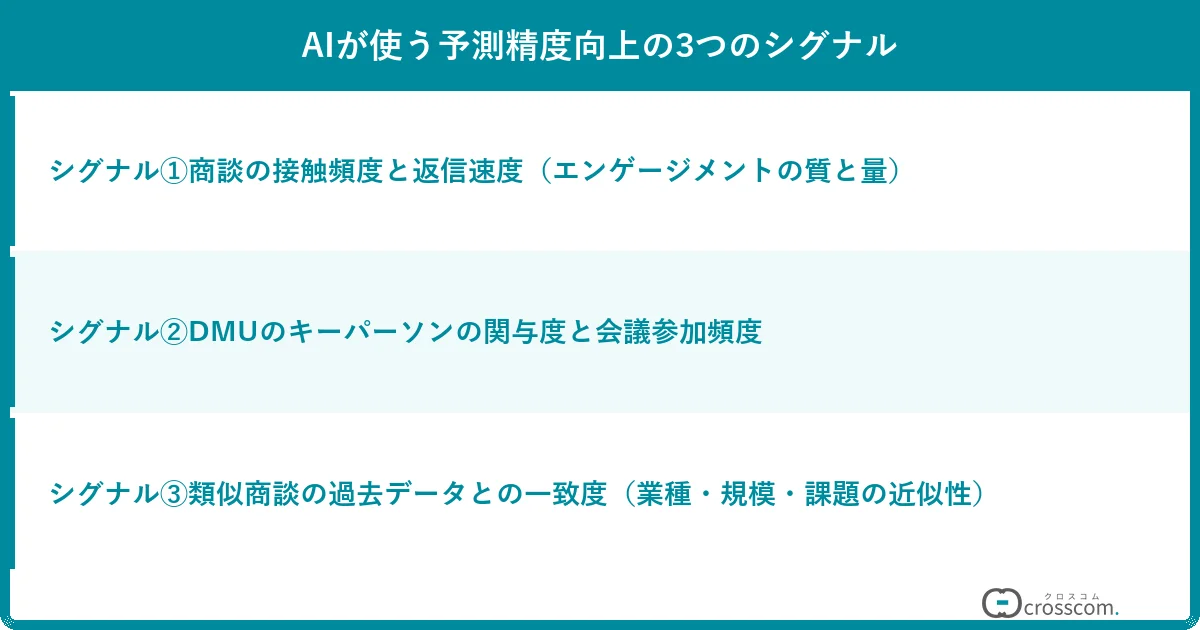
前章では、静的確度を動的確度に変える3つの仕組みを解説しました。では、AIは何を手がかりに受注確度を計算しているのでしょうか。ここでは、AIが予測の精度を高めるために使う3つのシグナルを解説します。
シグナル①商談の接触頻度と返信速度(エンゲージメントの質と量)
1つ目のシグナルは、商談の接触頻度と返信速度、つまり顧客とのエンゲージメントの質と量です。
なぜなら、やり取りの頻度が高く、返信が速い商談ほど、顧客の関心が高く受注に近いと考えられるからです。
たとえば、先ほどの予約管理システムの企業では、直近30日の往復回数と、こちらの連絡に対する平均返信時間を、AIが確度の計算に使うようにしました。毎週やり取りがあり、返信も1日以内に返ってくる商談は確度が高く算出され、2週間連絡が途絶えた商談は確度が下がります。担当者の印象よりも、実際のやり取りの記録が確度に反映されました。たとえ担当者が受注に自信を持っていても、やり取りが止まっていれば、AIは確度を自動で引き下げます。
このように、接触の頻度と速さは、受注の近さを映す確かなシグナルになります。
シグナル②DMUのキーパーソンの関与度と会議参加頻度
2つ目のシグナルは、DMU、つまり購買に関わる意思決定者のなかでも、キーパーソンの関与度と会議への参加頻度です。
なぜなら、現場担当者だけが動いている商談よりも、決裁権を持つキーパーソンが会議に出てくる商談のほうが、受注確度は高いからです。
たとえば、この企業では、商談に決裁者や部門長がどれだけ関与しているかを、会議の参加履歴や録音の発言からAIが判定するようにしました。相手ごとに渡す材料を変える設計はハイパーパーソナライゼーションの記事で整理しています。現場担当者としか接点のない商談は確度を控えめに、決裁者が直近の打ち合わせに出席した商談は確度を高めに算出します。ある商談では、部門長が会議に初めて参加した週に、AIが確度を大きく上げました。
このように、キーパーソンの関与は、商談がどれだけ前に進んでいるかを示すシグナルになります。
シグナル③類似商談の過去データとの一致度(業種・規模・課題の近似性)
3つ目のシグナルは、いま進行中の商談が、過去の受注・失注商談とどれだけ似ているかという一致度です。
なぜなら、業種・企業規模・抱える課題が過去の受注商談と近い商談は、同じように受注へ進む可能性が高いからです。
たとえば、先ほどの企業では、AIが過去の商談データを参照し、進行中の商談と業種・規模・課題が近い事例が、過去にどれだけ受注または失注したかを確度に反映しました。過去に同じ業種で高い確率で受注していれば確度は上がり、逆に類似商談がほとんど失注していれば確度は下がります。担当者一人の経験では気づけない傾向が、確度に織り込まれました。
接触頻度・キーパーソンの関与・過去商談との一致度という3つのシグナルを組み合わせることで、AIは担当者の感覚より精度の高い確度を導き出します。
場面3選|パイプライン予測が自律更新されるとき
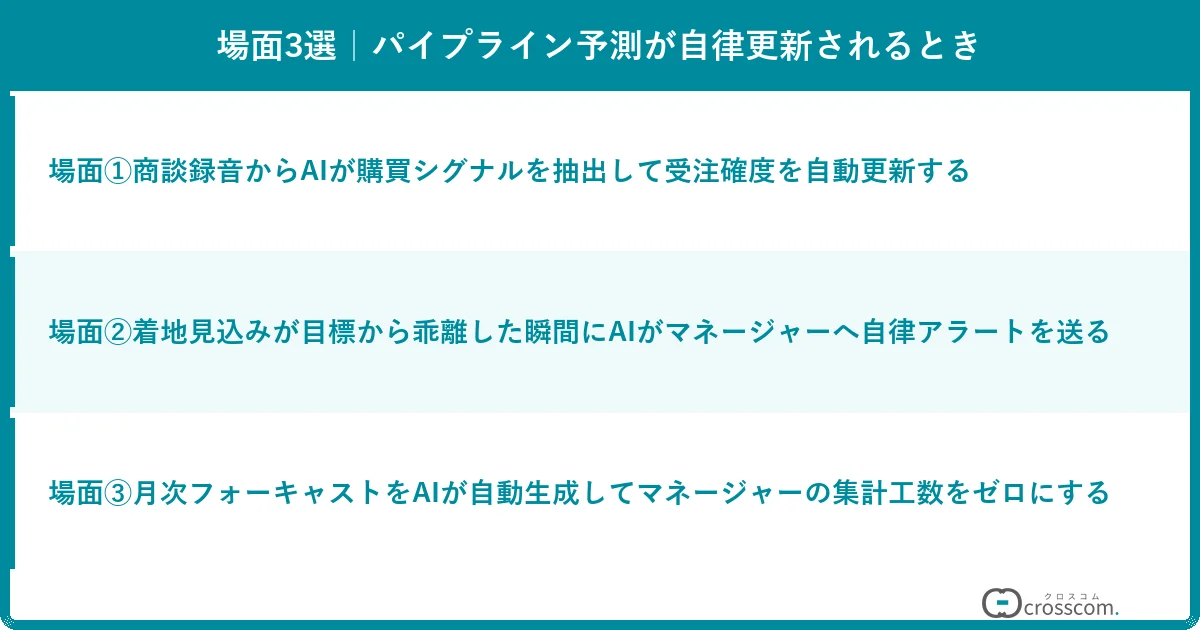
ここまで、AIが確度の計算に使う3つのシグナルを見てきました。では、それらをもとにAgentic CRMが実際にどう予測を更新するのでしょうか。ここでは、先ほどの予約管理システムの企業で、パイプライン予測をAIが自律的に更新した3つの場面を紹介します。
場面①商談録音からAIが購買シグナルを抽出して受注確度を自動更新する
1つ目の場面は、商談の録音からAIが購買のシグナルを抽出し、受注確度を自動で更新したケースです。
なぜなら、顧客が商談中に発した言葉には、確度を左右する重要な情報が含まれているからです。
たとえば、ある商談の録音で、顧客が「来期の予算に組み込みたい」と発言しました。AIはこの発言を購買の前向きなシグナルとして抽出し、その商談の確度を自動で上げました。別の商談で「他社もいくつか見ている」という発言が出たときは、競合の存在を検知して確度を下げました。担当者が議事録に書き起こすのを待たず、確度が更新されました。録音が残っていれば、担当者が聞き流していた発言まで、購買のシグナルとして確度に反映されます。
このように、対話の中身から確度を更新することで、予測は商談の実態にすばやく追いつきます。
場面②着地見込みが目標から乖離した瞬間にAIがマネージャーへ自律アラートを送る
2つ目の場面は、着地見込みが目標から離れた瞬間に、AIがマネージャーへ自律的にアラートを送ったケースです。
着地の下振れに月末まで気づけなければ、打てる手も打てなくなるからです。
たとえば、ある月の半ば、複数の商談で確度が同時に下がり、月次の着地見込みが目標を15%下回りました。AIはこの乖離を検知し、その日のうちにマネージャーへ「着地が目標を大きく下回る見込み」と通知しました。マネージャーは月末を待たず、確度の下がった商談の立て直しに動けました。以前は月末に判明していた下振れが、月の途中で分かるようになりました。下振れに早く気づけるほど、その月のうちに立て直せる商談の数も増えていきます。
このように、乖離をその場で知らせることで、マネージャーは早い段階で対処に動けます。
場面③月次フォーキャストをAIが自動生成してマネージャーの集計工数をゼロにする
3つ目の場面は、月次のフォーキャストをAIが自動で生成し、マネージャーの集計工数をなくしたケースです。
なぜなら、確度が常に最新であれば、フォーキャストは締め日に手作業で集計しなくても、いつでも自動で出せるからです。
たとえば、先ほどの企業では、以前はマネージャーが毎月末に各担当者の数字を集めて表計算でまとめていましたが、この作業がAIの自動生成に置き換わりました。海外でも、対話データを予測モデルに組み込むことで予測の誤差が縮んだ事例が報告されています。集計の手間が消え、マネージャーは数字づくりから商談の中身の議論に時間を移せました。
確度が常に最新に保たれれば、フォーキャストは手作業の集計なしに、いつでも実態に近い数字を示せるようになります。
なぜ外れる?パイプライン予測の失敗パターン3選
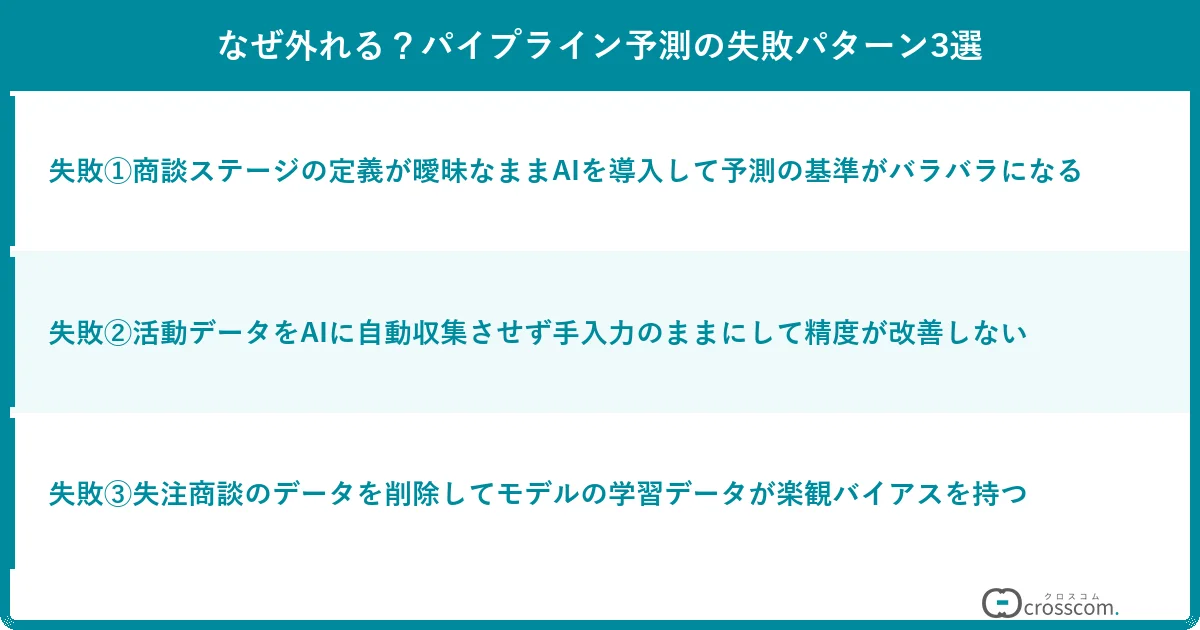
ここまで、Agentic CRMがパイプライン予測を自律更新する場面を見てきました。ただし、進め方を誤ると、AIを入れても予測の精度は上がりません。ここでは、予測精度の向上でAgentic CRMを使うときに陥りやすい3つの失敗パターンを整理します。
失敗①商談ステージの定義が曖昧なままAIを導入して予測の基準がバラバラになる
1つ目の失敗は、商談ステージの定義が曖昧なままAIを導入し、予測の基準がばらばらになることです。
なぜなら、AIが確度を計算する前提は商談ステージであり、その定義が担当者ごとに違えば、算出される確度も一貫しないからです。
たとえば、ある企業では、「提案」というステージに、初回提案から最終見積もりの提示までがすべて含まれていました。同じ「提案」でも中身がまるで違うため、AIはどの状態を基準に確度を出せばよいか定まりませんでした。ステージを提案・見積もり・稟議のように分け、それぞれの意味を揃えて初めて、AIの確度が安定しました。
このように、ステージの定義を先に整えなければ、AIを入れても予測の基準はそろいません。
失敗②活動データをAIに自動収集させず手入力のままにして精度が改善しない
2つ目の失敗は、活動データをAIに自動収集させず、手入力のままにして精度が改善しないことです。
手入力に頼ると、進行中商談のデータはどうしても欠け、AIが確度を計算する材料が不足するからです。
たとえば、ある企業では、AI予測の機能だけを導入し、活動データの自動連携は後回しにしていました。その結果、担当者が入力した断片的な記録しかAIに渡らず、確度の精度は導入前とほとんど変わりませんでした。商談録音やメール履歴を自動でCRMに集める仕組みを整えたところ、ようやく確度が実態に近づきました。AI予測の精度は、渡されるデータの量と質を超えることはできません。
このように、データの自動収集を伴わなければ、AI予測の精度は上がりません。
失敗③失注商談のデータを削除してモデルの学習データが楽観バイアスを持つ
3つ目の失敗は、失注した商談のデータを削除してしまい、AIの学習データが楽観バイアスを持つことです。
なぜなら、受注商談だけを残して失注商談を消すと、AIは「商談は受注するもの」と学習し、確度を実際より高く見積もるようになるからです。
たとえば、ある企業では、CRMを整理する目的で、失注した商談のデータを定期的に削除していました。その結果、AIが学習できるのは受注商談ばかりになり、進行中商談の確度を軒並み高く算出してしまいました。失注商談を残し、なぜ失注したかの記録もあわせて蓄積するように変えたところ、確度の楽観的な偏りが小さくなりました。
失注商談のデータは、AIが確度を正しく見積もるために欠かせず、消してはならない学習材料です。
予測精度の向上が機能する企業の条件
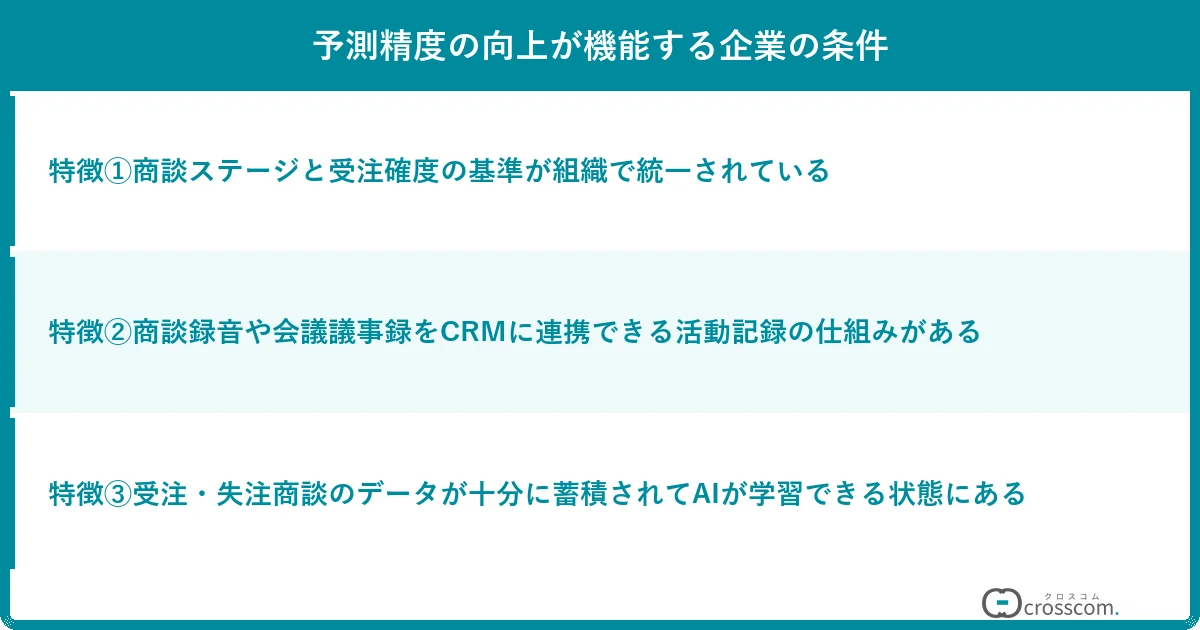
前章では、予測精度の向上でつまずきやすい失敗パターンを整理しました。では、どういう企業であればAgentic CRMを使った予測の精度向上がうまく機能するのでしょうか。ここでは、成果につながりやすい企業に共通する3つの特徴を解説します。
特徴①商談ステージと受注確度の基準が組織で統一されている
1つ目の特徴は、商談ステージと受注確度の基準が、組織全体で統一されていることです。
なぜなら、AIが確度を計算する前提がそろっていれば、算出される予測も一貫し、現場が結果を信頼できるからです。
たとえば、先ほどの予約管理システムの企業では、まず各ステージの定義と、そのステージで妥当な確度の範囲を、営業とマネージャーで合意しました。「提案ステージは30〜50%」というように基準がそろっていたため、AIが出す確度も納得感のあるものになりました。基準が共有されていたことが、AI予測を現場に受け入れさせる前提になりました。
このように、ステージと確度の基準が統一されていることが、予測精度を高める出発点になります。
特徴②商談録音や会議議事録をCRMに連携できる活動記録の仕組みがある
2つ目の特徴は、商談録音や会議の議事録を、CRMに連携できる活動記録の仕組みがあることです。
なぜなら、動的な確度の計算には、対話データを含む豊富な活動記録が必要だからです。
たとえば、この企業では、オンライン商談ツールとCRMが連携し、録音や文字起こしが自動で商談に紐づく仕組みが整っていました。この仕組みがあったからこそ、AIは対話の中身から購買シグナルを抽出し、確度に反映できました。もし録音がどこにも残らなければ、AIは担当者の入力した断片的なメモしか使えなかったはずです。録音や文字起こしが自動で商談に紐づく仕組みは、動的確度の質を大きく左右します。
このように、対話データをCRMに集める仕組みが、動的確度を支えます。
特徴③受注・失注商談のデータが十分に蓄積されてAIが学習できる状態にある
3つ目の特徴は、受注と失注の商談データが十分に蓄積され、AIが学習できる状態にあることです。
なぜなら、AIは過去の受注・失注のパターンから確度を導くため、学習に使えるデータの量と質が精度を左右するからです。
たとえば、先ほどの企業では、過去数年分の受注・失注商談が、失注理由まで含めてCRMに残っていました。このデータがあったからこそ、AIは「この業種・規模の商談は過去にどう決着したか」を確度に反映できました。データが数十件しかなければ、AIの予測は偶然に左右され、安定しなかったはずです。十分な件数の受注・失注データがあってこそ、AIは業種や規模ごとの受注傾向をつかめます。
受注と失注の両方のデータが十分にそろっていることが、AIの予測を安定させる条件です。
予測精度の向上を急がなくてよい企業の特徴
一方で、Agentic CRMを使った予測の精度向上を、今すぐ進めるべきでない企業もあります。前章の条件が欠けている場合は、先にデータと基準の整備を優先するほうが先決です。ここでは、導入を急ぐべきでない企業の3つの特徴を整理します。
特徴①商談ステージの定義が担当者ごとにバラバラで統一できていない
1つ目の特徴は、商談ステージの定義が担当者ごとにばらばらで、統一できていないことです。
なぜなら、ステージの意味がそろっていなければ、AIは確度を計算する基準を持てず、予測が安定しないからです。
たとえば、ある企業では、同じ「商談中」でも、ある担当者は初回接触から、別の担当者は見積もり提示後からそう呼んでいました。この状態でAIを入れても、確度の計算がばらつくばかりでした。まず必要なのは、AIの導入よりも先に、ステージの定義を全員で揃えることでした。定義がそろわないうちにAIを入れても、確度のばらつきが増えるだけです。
このように、ステージの定義が統一できていない段階では、予測精度の向上は望めません。
特徴②受注・失注のデータが少なくAIが予測モデルを学習できる商談数がない
2つ目の特徴は、受注と失注のデータが少なく、AIが予測モデルを学習できるだけの商談数がないことです。
なぜなら、AIは過去のパターンから確度を導くため、学習できる商談が少なければ、予測は当てにならないからです。
たとえば、事業を始めて間もない企業では、そもそも受注・失注の実績が数十件しかないこともあります。この量では、AIが「どんな商談が受注するか」の傾向を学ぶには足りません。まずは商談データを一定量ためることが、AI予測を使う前の準備になります。十分な実績がたまるまでは、まず商談を着実に記録することに専念するのが現実的です。
このように、学習に使える商談数がそろわないうちは、AI予測の導入は時期尚早です。
特徴③担当者のCRMへの活動記録への抵抗が強く入力データが断片的なまま
3つ目の特徴は、担当者のCRMへの記録に対する抵抗が強く、入力データが断片的なままになっていることです。
なぜなら、活動記録が断片的だと、たとえ自動連携を入れても、確度の計算に使えるデータがそろわないからです。
たとえば、ある企業では、営業担当が「記録より訪問」という考えが強く、商談の活動をほとんど残していませんでした。この状態では、AIに渡るデータが乏しく、確度の精度も出ません。まず記録が営業自身の役に立つと感じられる運用をつくることが、AI予測より先に必要でした。入力が習慣にならないうちは、自動連携を足しても、データの欠けは埋まりません。
記録への抵抗が残ったままでは、AIに渡るデータがそろわず、予測精度の向上は望めません。
どこから始める?パイプライン予測を自律更新する5ステップ
ここまで、予測精度の向上が機能する企業とそうでない企業の違いを見てきました。ここからは、実際にAgentic CRMでパイプライン予測を自律更新するまでの流れを、5つのステップに分けて解説します。先ほどの予約管理システムの企業が、どの順番で仕組みを整えたかに沿って進めます。
ステップ①商談ステージごとの定義と受注確度の基準をCRMに明文化する
まず取りかかるのは、商談ステージごとの定義と、受注確度の基準を、CRMに明文化することです。
予測のすべての前提は、どのステージがどういう状態を指し、そこでどのくらいの確度が妥当かという共通の物差しにあるからです。
たとえば、先ほどの企業では、接触・提案・見積もり・稟議という4つのステージを定義し、それぞれで妥当な確度の範囲を営業とマネージャーで合意しました。「見積もり提示後は50〜70%」というように、ステージと確度の対応をCRMに書き込みました。この共通の物差しが、後のAI算出の基準になりました。基準がCRMに書かれていれば、担当者が入れ替わっても確度の付け方はぶれません。
このように、ステージと確度の基準を明文化することが、自律更新の出発点になります。
ステップ②活動データをCRMに自動連携する仕組みを構築する
次に行うのが、活動データをCRMに自動で連携する仕組みを構築することです。
なぜなら、動的な確度の計算には、手入力では集めきれない対話データや往復履歴が必要だからです。
たとえば、この企業では、オンライン商談ツールの録音、メール、通話の履歴を、それぞれCRMに自動連携しました。担当者が入力しなくても、商談ごとにやり取りの記録が積み上がります。進行中商談のデータの欠けが減り、AIが確度を計算する材料がそろいました。連携さえ整えば、データ収集の手間は担当者からほとんど消えます。録音や履歴が自動でたまることで、記録にかかる担当者の負担も同時に減っていきます。
このように、活動データの自動連携が、動的確度の精度を支えます。
ステップ③受注確度を動的算出するAI予測ルールをCRMに設定する
そのうえで設定するのが、受注確度を動的に算出するAIの予測ルールを、CRMに組み込むことです。
集めたデータをもとに、どのシグナルをどう重みづけして確度を出すかを決めなければ、AIは確度を計算できないからです。
たとえば、先ほどの企業では、商談ステージ・接触頻度・キーパーソンの関与・類似商談との一致度を、AIが確度に反映するルールを設定しました。接触が途絶えれば確度が下がり、決裁者が関与すれば上がるというように、事実の変化が確度に自動で表れるようにしました。担当者の感覚に頼らない確度が、ここで初めて動き出しました。
予測ルールをCRMに組み込むことで、確度が担当者の感覚を離れ、事実にもとづいて自動更新されます。
ステップ④着地乖離アラートとマネージャーへの自律通知フローをCRMで実装する
続いて実装するのが、着地の乖離アラートと、マネージャーへの自律通知のフローを、CRM上で組むことです。
確度が動いても、着地の下振れをマネージャーが知る仕組みがなければ、対処にはつながらないからです。
たとえば、この企業では、月次の着地見込みが目標を一定以上下回ったら、AIがマネージャーへ自動でアラートを送るフローを実装しました。乖離が生じた日のうちに通知が届くため、マネージャーは月末を待たずに対処に動けます。どの商談の確度が下がって乖離が生じたかも、あわせて表示されるようにしました。原因の商談まで分かるため、マネージャーはすぐに立て直しの一手を打てます。
このように、乖離アラートを自動化することで、下振れへの初動が早まります。
ステップ⑤月次フォーキャストの自動生成スケジュールをCRMで設定する
最後に設定するのが、月次フォーキャストの自動生成のスケジュールを、CRMに組むことです。
なぜなら、確度が常に最新であれば、フォーキャストは締め日を待たず、決めたタイミングで自動的に出せるからです。
たとえば、先ほどの企業では、毎週月曜と月末に、AIが最新の確度をもとにフォーキャストを自動生成するよう設定しました。マネージャーが各担当者の数字を集めて表計算でまとめる作業は、なくなりました。生成された予測は、いつでも最新の商談状況を反映しています。締め日にまとめて集計する必要がなくなり、マネージャーは数字づくりの作業から解放されました。
以上が、Agentic CRMでパイプライン予測を自律更新する5つのステップでした。
パイプライン予測精度向上で追うフェーズ別KPI
前章では、予測を自律更新する5つのステップを解説しました。導入したら、次はその効果をどう測るかが問われます。ここでは、予測精度の向上の進み具合を測るKPIを、導入期・活用期・成果期の3つのフェーズに分けて解説します。
フェーズ①導入期:商談ステージごとのデータ完全性で測る
導入期にまず見るのは、商談ステージごとのデータの完全性です。
なぜなら、この時期の課題は、AIが確度を計算するために必要なデータが、各ステージでどれだけそろっているかを確かめることだからです。
たとえば、先ほどの予約管理システムの企業では、進行中商談のうち、次回アクション日や商談録音、接触履歴が埋まっている割合を、ステージごとに記録しました。導入当初は提案ステージのデータ完全性が半分ほどでしたが、自動連携を整えるにつれて、数週間で大きく上がりました。データがそろわないうちは、AIの確度も安定しません。どのステージのデータが欠けているかが分かれば、優先して埋めるべき箇所も見えてきます。
このように、導入期はデータの完全性を指標に置くことが重要です。
フェーズ②活用期:MAPE(平均絶対誤差率)の改善で測る(目標±10%→±5%台)
活用期に見るのは、予測の誤差の大きさ、つまりMAPE(平均絶対誤差率)の改善です。
検知や算出の仕組みが整ったら、次は実際に予測がどれだけ実績に近づいたかを、誤差の数字で確かめる必要があるからです。
たとえば、この企業では、月次の予測と実際の着地の差を、MAPEとして毎月記録しました。導入前は誤差が±10%を超えることも多かったものの、動的確度に切り替えてからは、誤差が±5%台まで縮まる月が増えました。AIを使った売上予測では、予測誤差が±10%から±5%程度へ改善したという報告もあります(2026年4月更新の記事)。※参考記事はこちら誤差を毎月記録すると、予測がどのくらい実績に近づいているかを客観的に追えます。
このように、活用期はMAPEの改善を指標に置きます。
フェーズ③成果期:フォーキャスト精度と着地実績の乖離率で測る
成果期に見るのは、フォーキャストの精度と、実際の着地との乖離率です。
なぜなら、予測精度の向上の最終的な狙いは、月初に立てた見込みと実際の着地のズレを小さくし、着地を正確に読めるようにすることだからです。
たとえば、先ほどの企業では、動的確度に切り替える前、月次フォーキャストと着地の乖離は毎月20%以上ありました。導入から半年後、この乖離は8%以内に収まる月が増え、フォーキャストの精度も68%から86%へ上がりました。当初の「着地が読めず経営への報告が二転三転する」という課題から始まった取り組みが、着地を正確に読めるという成果に表れたのです。
成果期はフォーキャスト精度と乖離率を指標に置くことで、着地を正確に読めるようになったかを確かめられます。
なお、KPIの設計全般はBtoBマーケティングのKPI設計ガイドで解説していますので、あわせて参考にしてもらえると嬉しいです。
パイプライン予測精度向上の費用感
KPIの見方を整理したところで、次に気になるのが費用です。ここでは、Agentic CRMを使ったパイプライン予測精度向上にかかる費用を、3つの観点から整理します。金額は構成によって幅があるため、ここでは考え方と目安を示します。
費用①活動データ自動収集とAI予測機能のライセンス費用の目安
1つ目の費用は、活動データの自動収集とAI予測機能を使うためのライセンス費用です。
なぜなら、動的な確度は、対話データを自動で集める機能と、確度を算出するAI機能があって初めて実現するからです。
たとえば、商談録音やメール履歴を自動でCRMに集める機能や、確度を算出するAI機能は、多くの場合、既存のCRMライセンスに追加する形で費用が発生します。利用するユーザー数や、AIの処理量に応じて課金される会話単位の課金方式が採られることもあります。先ほどの企業では、まず営業12名分から始め、効果を見ながら範囲を広げました。全社に一度に広げず、成果を確認しながら対象を増やすことで、無駄な費用を抑えられます。
ライセンス費用は利用人数と機能の範囲で変わるため、小さく始めて効果を見ながら広げるのが現実的です。
費用②予測モデル設計・データ統合にかかる外部支援費用の目安
2つ目の費用は、予測モデルの設計やデータの統合を外部に依頼する場合の支援費用です。
どのシグナルをどう重みづけして確度を算出するかの設計や、散らばったデータの統合は、自社だけで詰めるのが難しい場合があるからです。
たとえば、先ほどの企業では、確度の算出ルールの設計と、商談録音ツールとCRMのデータ統合を、外部の支援会社に依頼しました。自社の受注・失注データを分析し、どのシグナルが受注に効いているかを一緒に見極めてもらいました。この初期設計を外部と組んだことで、精度の出ない状態を早く抜け出せました。自社だけで確度のルールを設計しようとすると、どのシグナルが受注に効くかの判断で手が止まりがちです。
このように、初期の設計とデータ統合に外部支援を使うと、立ち上げの精度と速度を高められます。
費用③フォーキャスト精度のPDCA運用コストの目安
3つ目の費用は、フォーキャストの精度を継続的に改善するPDCAの運用コストです。
なぜなら、予測ルールは、一度決めたら固定でよいものではないからです。実績とのズレを見ながら、調整を続ける必要があります。
たとえば、この企業では、毎月、予測と着地のズレを振り返り、どのシグナルの重みを調整すべきかを見直していました。市場や商材が変われば、受注に効くシグナルも変わります。こうした調整を続ける工数、あるいは外部への運用支援の費用が、継続コストとして発生します。見直しを止めると、AIの確度は少しずつ実態からずれていきます。
このように、予測精度は運用しながら高めるため、継続的な調整のコストを見込んでおくことが重要です。
【一問一答】Agentic CRMを使ったパイプライン予測精度向上でよくある質問
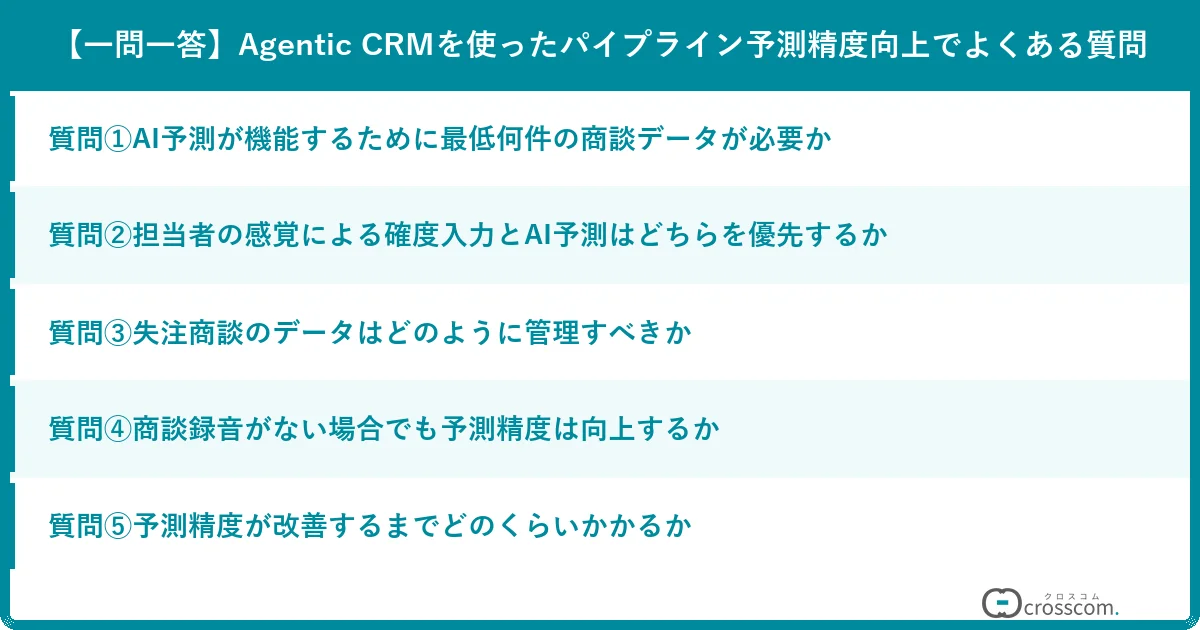
ここまで、予測精度向上の設計から費用までを解説してきました。最後に、パイプライン予測の精度向上でよく寄せられる質問に答えていきます。
明確な最低ラインはありませんが、受注と失注をあわせて数百件ほどの実績があると、AIは業種や規模ごとの傾向をつかみやすくなります。この記事で例に挙げた予約管理システムの企業も、営業12名分の商談から始め、効果を見ながら対象を広げました。数十件では偶然に左右されやすく、予測が安定しません。
基本はAI予測を基準にし、担当者の感覚は補足として扱うのが現実的です。この企業では、楽観的な担当者が提案前の商談に確度60%を入れ、慎重な担当者は受注寸前でも50%のままにしており、感覚を積み上げても意味を持ちませんでした。担当者しか知らない社内の事情はあるため、両者が食い違うときは、その理由を確認したうえで確度を調整します。
失注商談は削除せず、失注の理由まで含めて残すことが重要です。受注商談だけを残すと、AIが確度を高く見積もる楽観バイアスにつながります。この企業で月末の数日に着地が20%以上も下振れしていたのは、決まらないと判断された商談の記録が後から消えていたことも一因でした。なぜ失注したのかの記録が、AIの予測精度を支える材料になります。
録音がなくても、活動履歴や次回アクション日、メールの往復といったデータがそろえば、一定の精度向上は見込めます。この企業がAIの計算に使ったのも、直近30日の往復回数と、こちらの連絡に対する平均返信時間でした。ただし、対話データがあるほうが、顧客の懸念や競合の存在といった確度を左右する情報を拾えます。
データの整備状況によりますが、活動データの自動連携とステージ定義が整っていれば、数週間から数か月で誤差の縮小が見え始めます。この企業では、動的確度に切り替えてから誤差が±5%台に収まる月が増え、導入から半年後にフォーキャストと着地の乖離が8%以内へ、精度は68%から86%へ変わりました。
パイプライン予測がブレる本質的な原因は「担当者の感覚値」と「CRMデータの劣化」にある。Agentic CRMは活動データを自動収集してAIが受注確度を動的更新することで予測誤差を縮小する
パイプライン予測が毎月ブレる本質的な原因は、受注確度が担当者の感覚値に委ねられていることと、進行中商談のCRMデータが不完全なままだということにあります。本記事では、この原因を、確度を固定して扱う「静的確度」から、AIが常時見直す「動的確度」へと変える観点で解説してきました。活動データの自動収集から、確度の動的算出、乖離アラート、フォーキャストの自動生成までを、一連の流れとして整理しています。
予測の精度は、担当者の勘を磨くことよりも、AIが使えるデータをどれだけそろえられるかで決まります。商談録音や会議メモまで自動で集め、AIが事実にもとづいて確度を更新できれば、月末まで着地が読めないという状態から、いつでも実態に近い予測を持てる状態へと変わります。まずは商談ステージと確度の基準を統一するところから、自社の予測精度を高めてみてはいかがでしょうか。合同会社クロスコムでは、活動データをAIが横断して読む前提でのAgentic CRM設計支援を行っています。対象を1つの商談区分に絞ったスモールスタートから対応していますので、Agentic CRM設計支援までお気軽にご相談ください。本記事が、その一助になれば幸いです。